AI 크롤러 robots.txt 설정, 막을까 열어 둘까
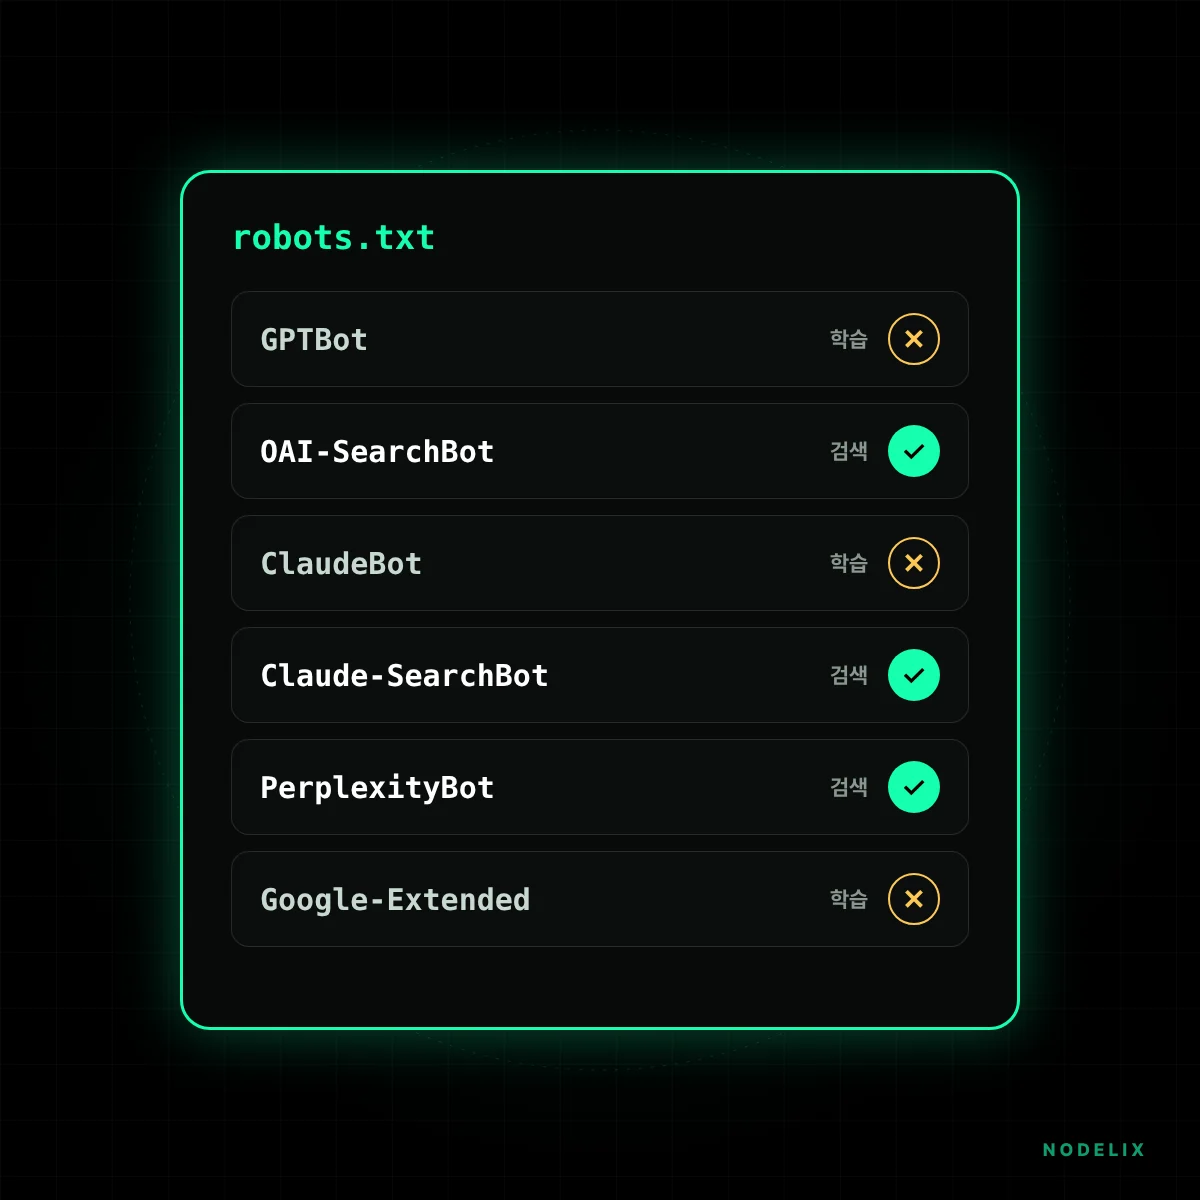
"AI가 우리 글을 학습하는 건 싫은데, ChatGPT나 AI 검색에는 나오고 싶다." 요즘 사이트 운영자에게 가장 많이 받는 질문입니다. 결론부터 말하면 대부분 가능합니다. 주요 AI 회사들이 학습용 크롤러와 검색용 크롤러를 따로 운영하고 있어서, robots.txt에서 이름별로 다르게 설정할 수 있기 때문입니다. 반대로 이름을 헷갈려 잘못 막으면 AI 검색 노출만 사라지는 일도 생깁니다. 이 글은 주요 AI 크롤러의 이름과 역할, 목적별 robots.txt 예시, 설정 후 확인 방법까지 정리했습니다.
📌 3분 요약
- AI 크롤러는 크게 학습용, 검색용, 사용자 요청용 세 종류입니다. 회사마다 이름이 다릅니다.
- OpenAI는 GPTBot(학습)·OAI-SearchBot(ChatGPT 검색)·ChatGPT-User(사용자 요청), Anthropic은 ClaudeBot·Claude-SearchBot·Claude-User로 나뉩니다.
- 구글의 Google-Extended는 별도 크롤러가 아니라 Gemini 학습 등에 쓰일지 정하는 표시입니다. 막아도 구글 검색과 AI 개요 노출에는 영향이 없다고 안내됩니다.
- "학습은 막고 검색 노출은 유지"하려면 학습용만 Disallow하고 검색용은 열어 둡니다.
- robots.txt는 약속일 뿐 강제 차단이 아닙니다. 확실히 막아야 한다면 서버·CDN 방화벽을 함께 씁니다.
AI 크롤러의
세 종류
"AI 크롤러"라고 한데 묶어 부르지만, 실제로는 목적이 다른 세 종류가 있습니다. 이 구분을 알아야 원하는 것만 막을 수 있습니다.
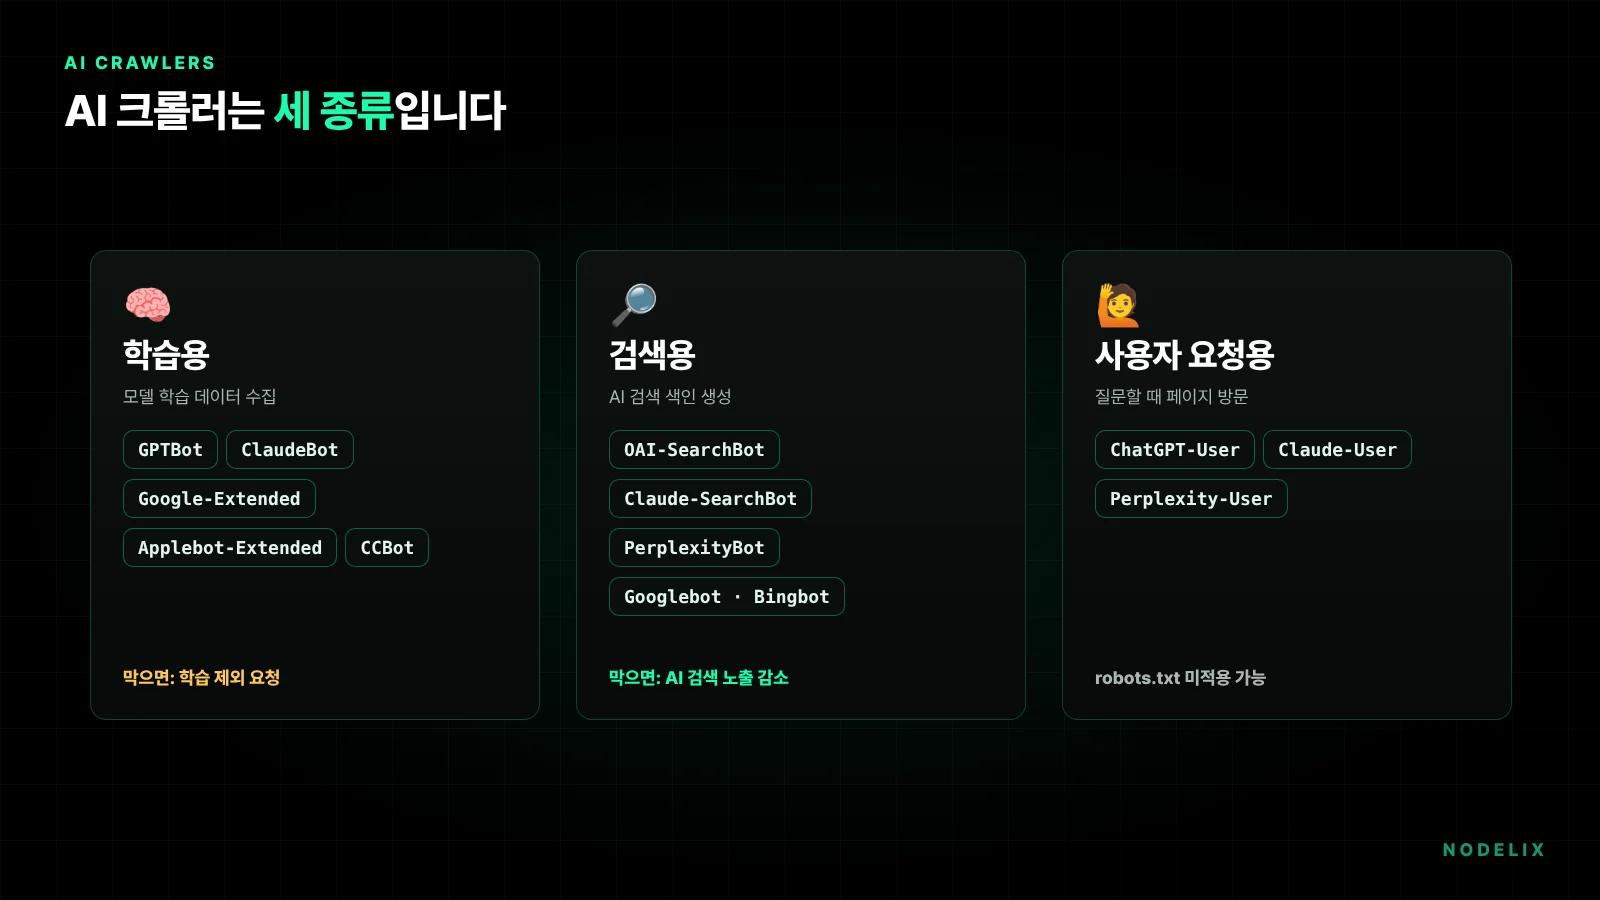
학습용
AI 모델을 학습시키는 데이터를 모읍니다. 막으면 앞으로의 학습에서 제외해 달라는 뜻이 됩니다.
검색용
AI 검색 서비스의 색인을 만듭니다. 막으면 해당 AI 검색 답변에 출처로 나오기 어려워집니다.
사용자 요청용
사용자가 질문하거나 링크를 줄 때 그 순간 페이지를 가져옵니다. 일부는 robots.txt를 따르지 않을 수 있다고 안내합니다.
그래서 "AI를 막는다"는 결정은 사실 "어떤 용도를 막을 것인가"라는 질문입니다. 학습은 막고 검색 노출은 원하는 사이트가 많은 이유도 여기에 있습니다.
주요 AI 크롤러
이름과 역할
robots.txt에서는 아래의 User-agent 이름으로 대상을 지정합니다. 이름은 바뀌거나 추가될 수 있으므로, 설정 전에 각 회사의 공개 문서를 다시 확인하는 것이 좋습니다.
| 회사 | User-agent | 용도 | 막으면 |
|---|---|---|---|
| OpenAI | GPTBot | 모델 학습 | 학습 데이터에서 제외 요청 |
| OAI-SearchBot | ChatGPT 검색 | ChatGPT 검색 답변에 표시되지 않음(이동용 링크로만 나올 수 있음) | |
| ChatGPT-User | 사용자 요청 시 방문 | 사용자 요청이라 robots.txt가 적용되지 않을 수 있음 | |
| Anthropic | ClaudeBot | 모델 학습 | 학습 데이터에서 제외 요청 |
| Claude-SearchBot | Claude 검색 색인 | Claude 검색 결과 노출·정확도 감소 | |
| Claude-User | 사용자 요청 시 방문 | 사용자 질문에 대한 답변에서 노출 감소 | |
| Perplexity | PerplexityBot | Perplexity 검색 노출(학습용 아님) | Perplexity 검색 결과에서 노출 감소 |
| Perplexity-User | 사용자 요청 시 방문 | 일반적으로 robots.txt를 따르지 않는다고 안내 | |
| Googlebot | 구글 검색, AI 개요·AI 모드 | 구글 검색 전체에서 사라짐(막으면 안 됨) | |
| Google-Extended | Gemini 학습·응답 근거 사용 여부 표시 | 검색 노출과 순위에는 영향 없음 | |
| Apple | Applebot-Extended | Apple AI 모델 학습 사용 여부 표시 | Applebot의 검색용 수집은 유지 |
| Microsoft | Bingbot | Bing 검색, Copilot 답변의 기반 | Bing·Copilot 모두에서 노출 감소 |
| Common Crawl | CCBot | 공개 웹 데이터셋 수집(여러 AI 학습에 활용) | 데이터셋 수집 제외 요청 |
| ByteDance | Bytespider | ByteDance 서비스용 수집 | 수집 제외 요청 |
근거 문서: OpenAI 크롤러 개요, Anthropic 크롤러 안내, Perplexity 크롤러 안내, Google 크롤러 목록. OpenAI는 robots.txt 변경이 시스템에 반영되기까지 약 24시간이 걸릴 수 있다고 안내합니다.
구글: Googlebot과
Google-Extended
가장 많이 헷갈리는 부분이 구글입니다. 구글 검색 결과 위에 보이는 AI 개요와 AI 모드는 별도의 AI 크롤러가 아니라 Googlebot이 수집·색인한 페이지를 바탕으로 만들어집니다. 그래서 AI 개요에 나오기 싫다고 Googlebot을 막으면 일반 검색 결과에서도 사라집니다.
Google-Extended는 별도로 사이트를 방문하는 크롤러가 아니라, robots.txt에 적는 사용 범위 표시입니다. 이를 막으면 구글이 수집한 콘텐츠를 Gemini 모델 학습과 응답 근거로 쓰지 말아 달라는 뜻이 되며, 구글은 이것이 검색 노출이나 순위에 영향을 주지 않는다고 설명합니다.
💡 AI 개요에 나오는 방식을 조절하고 싶다면
- robots.txt가 아니라 nosnippet, data-nosnippet, max-snippet 같은 스니펫 설정으로 조절합니다.
- 다만 이 설정은 일반 검색 결과의 설명 문구(스니펫)에도 함께 적용되므로, 꼭 필요한 페이지·문단에만 씁니다.
- noindex를 쓰면 검색 결과 자체에서 빠집니다.
막을까, 열어 둘까:
목적별 판단
정답은 사이트의 목적에 따라 다릅니다. 아래 기준으로 먼저 방향을 정하세요.
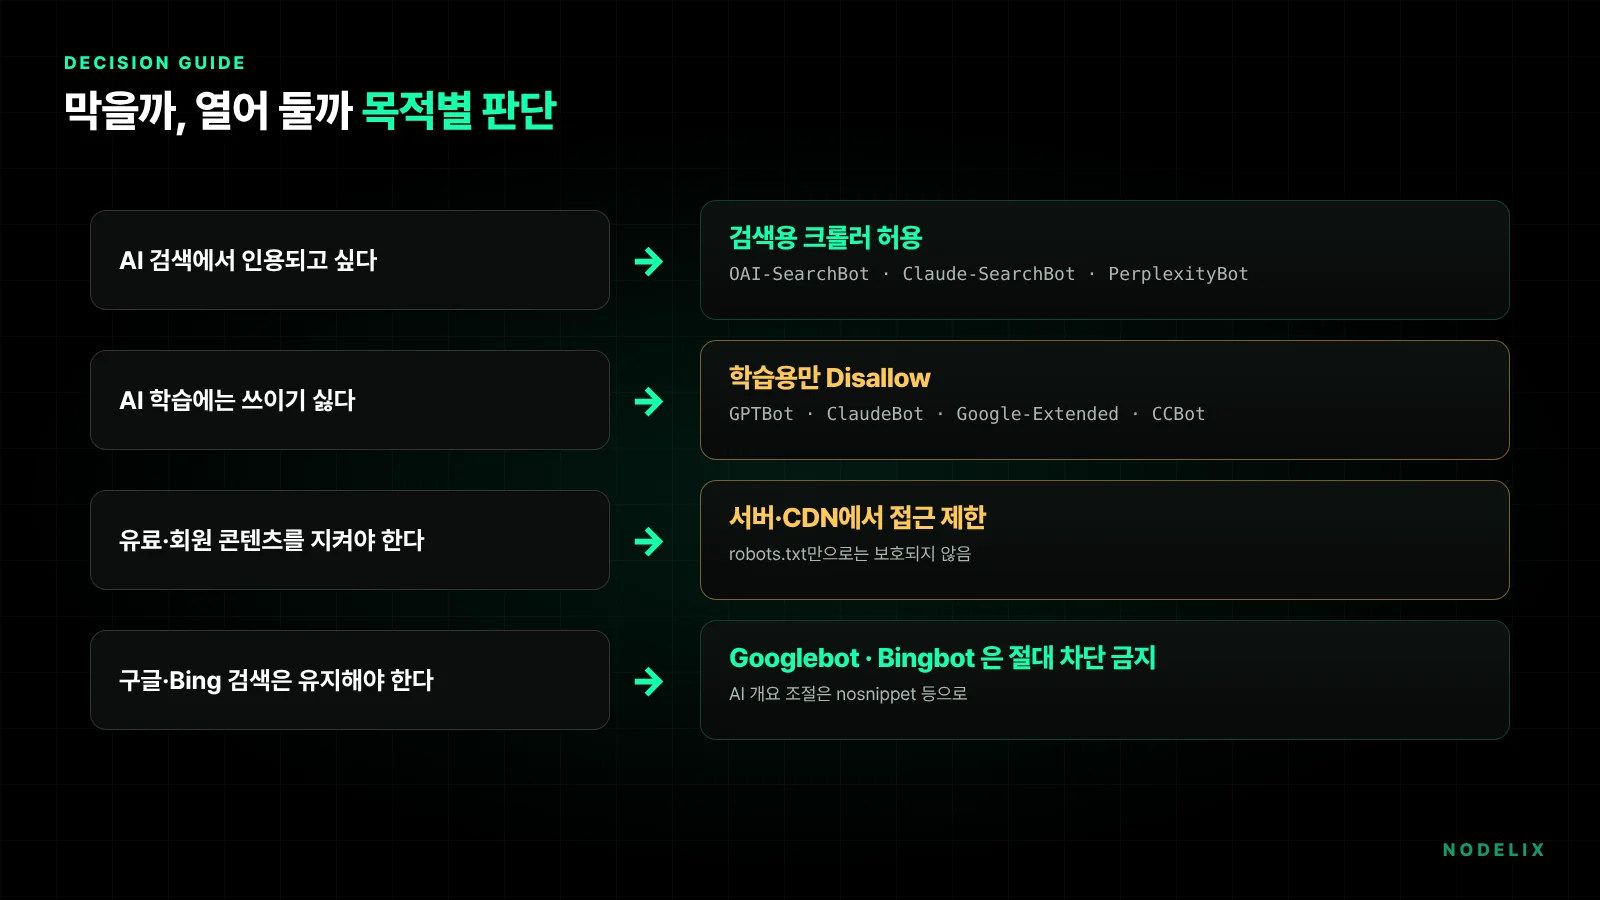
| 사이트 유형 | 권장 방향 | 이유 |
|---|---|---|
| 서비스·브랜드 홈페이지 | 검색용 허용, 학습용은 선택 | AI 검색에서 브랜드가 언급·인용되는 것이 문의로 이어짐 |
| 정보성 블로그·미디어 | 검색용 허용, 학습용 차단 검토 | 출처 표시와 유입은 원하지만 원문 학습 사용은 부담 |
| 유료 콘텐츠·회원 전용 | 서버에서 접근 제한 | robots.txt만으로는 보호되지 않음 |
| 쇼핑몰 | 검색용 허용, 장바구니·내부 검색 경로 차단 | 상품 정보 노출은 이득, 의미 없는 URL 수집은 낭비 |
AI 검색에서 출처로 인용되는 것이 목표라면, 검색용 크롤러를 막는 순간 그 서비스에서의 노출 기회도 함께 사라진다는 점을 기억하세요. AI 검색에서 인용되는 원리는 GEO(생성형 엔진 최적화)란?에 정리해 두었습니다.
목적별
robots.txt 예시
robots.txt는 사이트 최상위 경로(예: https://example.com/robots.txt)에 둡니다. 크롤러는 자기 이름이 적힌 그룹을 따르고, 없으면 User-agent: * 그룹을 따릅니다. 아래 예시는 기존 설정에 추가하는 형태로 참고하세요.
예시 1. 학습은 막고 AI 검색 노출은 유지
# 학습용 크롤러·표시
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: CCBot
Disallow: /

# 검색용 크롤러는 허용
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
예시 2. 모두 허용하되 특정 경로만 제외
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /cart/
Disallow: /search

Sitemap: https://example.com/sitemap.xml
예시 3. AI 크롤러 전체 차단 (신중하게)
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /
예시 3처럼 여러 User-agent를 한 그룹에 나열할 수 있습니다. 다만 이렇게 막으면 ChatGPT 검색, Claude 검색, Perplexity에서 출처로 나올 기회도 함께 줄어듭니다. Googlebot과 Bingbot은 절대 이 목록에 넣지 마세요. 넣으면 구글·Bing 검색 자체에서 사라집니다.
⚠️ 자주 하는 실수
- User-agent: * 에 Disallow: /: 모든 검색엔진을 막아 사이트 전체가 검색에서 사라집니다.
- 이름 오타·옛 이름 사용: 대소문자나 하이픈이 다르거나 더 이상 쓰지 않는 이름이면 적용되지 않습니다.
- CSS·JS·이미지 경로 차단: 검색엔진이 페이지를 제대로 그리지 못해 평가에 불리할 수 있습니다.
- robots.txt로 개인정보 숨기기: robots.txt는 누구나 볼 수 있는 공개 파일이라 오히려 경로를 알려 주는 셈입니다.
robots.txt의 한계와
함께 쓸 방법
robots.txt는 크롤러에게 "이렇게 해 달라"고 요청하는 공개 약속입니다. 주요 회사의 공식 크롤러는 이를 따른다고 밝히지만, 기술적으로 접근을 막는 장치는 아닙니다.
- 사용자 요청형 에이전트: ChatGPT-User, Perplexity-User처럼 사용자가 직접 요청한 방문은 robots.txt가 적용되지 않을 수 있다고 각 회사가 안내합니다.
- 이름을 숨긴 수집기: 공식 이름을 쓰지 않는 수집기는 robots.txt로 구분할 수 없습니다.
- 확실한 차단이 필요하다면: 서버나 CDN의 방화벽 규칙, 봇 관리 기능으로 접근 자체를 막습니다. Cloudflare 같은 CDN은 AI 크롤러 차단 기능을 제공합니다.
- 사용 의사 표시: robots.txt에
Content-Signal: search=yes, ai-train=no처럼 용도별 의사를 적는 형식도 제안되어 있습니다. 강제력은 없으며 따를지는 각 회사의 판단입니다.
AI 학습 사용 여부를 정하는 표시와 별개로, AI가 사이트를 잘 읽게 돕는다는 llms.txt에 대해서는 아직 제안 단계라는 점을 GEO 기초 가이드에서 정리했습니다.
설정 후
확인하는 법
파일이 열리는지
브라우저에서 https://우리도메인/robots.txt 를 열어 수정 내용이 그대로 보이는지 확인합니다. CDN 캐시가 남아 있으면 반영이 늦을 수 있습니다.
검색 크롤러를 막지 않았는지
Search Console의 robots.txt 보고서에서 구글이 파일을 정상적으로 읽었는지, 중요한 페이지가 차단되지 않았는지 확인합니다.
서버 로그 확인
접속 기록의 User-agent에서 GPTBot, OAI-SearchBot, ClaudeBot 같은 이름이 어떤 경로에 오는지 봅니다. 차단한 크롤러가 계속 오면 이름과 규칙을 다시 확인합니다.
진짜 크롤러인지 검증
User-agent는 누구나 흉내 낼 수 있습니다. OpenAI·Perplexity·구글 등은 크롤러 IP 대역을 공개하므로, 방화벽 규칙은 IP 확인과 함께 설정하는 것이 정확합니다.
AI 검색에서 반복 확인
설정 변경 후 며칠이 지나 주요 질문을 AI 검색에 다시 물어보고, 출처 표시가 어떻게 바뀌는지 기록합니다.
NODELIX는
어떻게 설정했나
참고로 이 사이트(nodelix.kr)는 검색과 AI 답변에서 출처로 인용되는 것을 우선해 아래처럼 설정하고 있습니다. 실제 파일은 nodelix.kr/robots.txt에서 누구나 확인할 수 있습니다.
- 모든 검색엔진은 관리자 경로 등 일부를 제외하고 허용
- Google-Extended, GPTBot, ClaudeBot, Applebot-Extended는 허용
- Bytespider, CCBot은 차단
- Content-Signal로 검색·AI 답변 근거 사용은 허용(search=yes, ai-input=yes), 학습 사용은 원하지 않음(ai-train=no)을 함께 표시
이 설정은 "AI 답변에 정확하게 소개되는 것이 원문 보호보다 중요한" 서비스 회사의 선택입니다. 원문 자체가 상품인 미디어나 유료 콘텐츠 사이트라면 학습용 크롤러는 막는 쪽이 맞을 수 있습니다. 정답은 하나가 아니라, 우리 사이트가 AI에게서 무엇을 얻고 무엇을 지키려는지에 따라 정해집니다.
자주 묻는 질문
GPTBot을 막으면 ChatGPT 검색에도 안 나오나요?
Google-Extended를 막으면 구글 검색 순위가 떨어지나요?
구글 AI 개요에 우리 글이 나오지 않게 할 수 있나요?
학습은 막고 AI 검색 노출은 유지할 수 있나요?
robots.txt로 막으면 AI가 우리 사이트를 절대 못 보나요?
AI 크롤러를 모두 막는 것이 안전한가요?
Googlebot이나 Bingbot도 AI 크롤러로 보고 막아야 하나요?
robots.txt를 바꾸면 언제 반영되나요?
진짜 AI 크롤러인지 어떻게 확인하나요?
결론: 이름을 알고
목적대로
AI 크롤러 설정은 "막는다/연다"의 문제가 아니라 어떤 용도를 허락할지의 문제입니다. 오늘 확인할 것은 세 가지입니다.
목적 정하기
AI 검색 노출과 학습 사용 중 무엇을 원하고 무엇을 피할지 정합니다.
이름별 설정
학습용·검색용 User-agent를 구분해 robots.txt에 적고, Googlebot·Bingbot은 막지 않습니다.
반영 확인
파일 공개 상태, Search Console, 서버 로그, AI 검색 결과로 실제 반영을 확인합니다.
우리 사이트는 AI 검색에
제대로 열려 있을까요?
robots.txt와 보안 설정이 의도치 않게 AI 검색 크롤러를 막고 있지 않은지, AI 답변에서 우리 브랜드가 어떻게 보이는지 궁금하다면 사이트 주소를 남겨 주세요. 검토 후 설정 방향을 안내드립니다.
무료 SEO 진단 신청
